跳到主要内容
AGORA MODEL FARM

让模型,
在设备上运行。

从视觉感知到语言推理,发现适合你的端侧 AI 模型。
选择设备、比较性能,带着部署指南开始构建。

12 类 AI 任务多平台部署6 篇上手指南
DISCOVER

发现你感兴趣的端侧模型

从任务出发,找到适合设备的 AI 能力

57 个模型

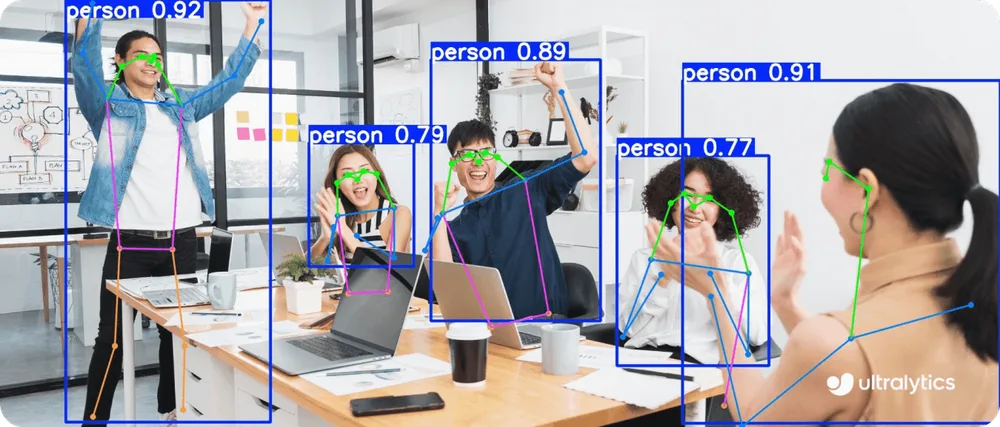
  • YOLOv8n 官方介绍图;非本站板卡实测画面目标检测部署指南
    UltralyticsAGPL-3.0

    YOLOv8n

    轻量级目标检测,识别 80 类常见物体。适合实时摄像头分析与端侧检测应用。

    实时检测COCO 80类W8A8
  • Qwen3-4B-Instruct-2507 官方介绍图;非本站板卡实测画面大语言模型部署指南
    QwenApache-2.0

    Qwen3-4B-Instruct-2507

    4B 参数指令模型,支持多轮对话、知识问答与工具调用,面向本地智能助手。

    本地对话指令跟随W4A16
  • SAM2-tiny 官方介绍图;非本站板卡实测画面图像分割部署指南
    Meta AIApache-2.0

    SAM2-tiny

    通过点或框提示分割图像中的目标,轻量编码器适合交互式标注与视觉应用。

    提示分割交互标注FP16
  • Depth-Anything-V2-Small 官方介绍图;非本站板卡实测画面深度估计部署指南
    Depth AnythingApache-2.0

    Depth-Anything-V2-Small

    从单张 RGB 图像预测相对深度,保留物体轮廓与场景细节,适合空间感知原型。

    单目深度空间感知FP16
  • Whisper-tiny 官方介绍图;非本站板卡实测画面语音识别部署指南
    OpenAIMIT

    Whisper-tiny

    紧凑的多语言语音识别模型,将音频转为文字,适合离线转写与语音交互原型。

    多语言离线转写FP16
  • PP-OCRv6-Small 官方介绍图;非本站板卡实测画面文字识别部署指南
    PaddlePaddleApache-2.0

    PP-OCRv6-Small

    轻量文字检测与识别管线,提取图像中的文字、置信度及位置,适合文档和工业读码。

    文字检测中文识别FP16
  • YOLOv5s 官方介绍图;非本站板卡实测画面目标检测
    UltralyticsAGPL-3.0

    YOLOv5s

    轻量级实时目标检测模型,具有较快的推理速度和较高的检测精度

    目标检测端侧AIW8A8
  • YOLOv11n 官方介绍图;非本站板卡实测画面目标检测
    UltralyticsAGPL-3.0

    YOLO11n

    一种先进的实时目标检测模型,专注于在高效计算的同时提升检测精度,广泛应用于自动驾驶和安防等领域。

    目标检测端侧AIFP16
  • YOLOv8s 官方介绍图;非本站板卡实测画面目标检测
    UltralyticsAGPL-3.0

    YOLOv8s

    YOLO系列中的轻量级模型,具备更高效的目标检测能力,结合了速度与精度的改进,适用于实时应用场景。

    目标检测端侧AIFP16
  • YOLOX-s 官方介绍图;非本站板卡实测画面目标检测
    MegviiApache-2.0

    YOLOX-s

    一种改进的 YOLO 系列目标检测模型,具有更高精度与灵活性

    目标检测端侧AIFP16
  • YOLO-NAS-s 官方介绍图;非本站板卡实测画面目标检测
    DeciYOLO-NAS License

    YOLO-NAS-s

    一种基于神经架构搜索(NAS)优化的目标检测模型,能够自动搜索和调整网络结构,以实现更高的检测精度和效率。

    目标检测端侧AIFP16
  • DETR-ResNet50 官方介绍图;非本站板卡实测画面目标检测
    Meta AIApache-2.0

    DETR ResNet-50

    一种结合Transformer架构和ResNet50骨干网络的模型,专用于目标检测任务,具有强大的特征提取能力

    目标检测端侧AIFP16
  • Grounding-DINO-Tiny 官方介绍图;非本站板卡实测画面目标检测
    IDEA ResearchApache-2.0

    Grounding-DINO-Tiny

    轻量级文本指代目标检测(开集检测)基础模型

    目标检测端侧AIFP16
  • MobileNet-v2 官方介绍图;非本站板卡实测画面图像分类
    Google ResearchApache-2.0

    MobileNetV2

    一种轻量化卷积神经网络,针对移动设备进行了优化,在保持准确性的同时大幅减少计算资源需求。

    图像分类端侧AIFP16
  • MobileNet-v3-Small 官方介绍图;非本站板卡实测画面图像分类
    Google ResearchBSD-3-CLAUSE

    MobileNet-v3-Small

    一种轻量化卷积神经网络,针对移动设备进行了优化,在保持准确性的同时大幅减少计算资源需求

    图像分类端侧AIFP16
  • ResNet-50 官方介绍图;非本站板卡实测画面图像分类
    Microsoft ResearchBSD-3-CLAUSE

    ResNet-50

    深度残差神经网络,使用50层结构,通过引入残差连接有效解决深层网络中的梯度消失问题,广泛用于图像分类任务

    图像分类端侧AIFP16
  • EfficientNet-B0 官方介绍图;非本站板卡实测画面图像分类
    Google ResearchBSD-3-CLAUSE

    EfficientNet-B0

    一种轻量化高效的卷积神经网络,采用复合缩放方法,在减少计算资源的同时保持高精度

    图像分类端侧AIFP16
  • OpenAI-CLIP (ViT-B/16) 官方介绍图;非本站板卡实测画面图像分类
    OpenAIMIT

    OpenAI-CLIP-ViT-B16

    连接文本与图像的多模态对齐基础模型

    零样本分类图文对齐FP16
  • MobileSAM 官方介绍图;非本站板卡实测画面图像分割
    Chaoning Zhang et al.Apache-2.0

    MobileSAM

    一种轻量级通用图像分割模型,源自 Segment Anything,针对边缘设备优化,支持高效实时分割

    语义分割端侧AIFP16
  • FastSAM-S 官方介绍图;非本站板卡实测画面图像分割
    CASIAAGPL-3.0

    FastSAM-S

    高效的图像分割模型,具有轻量化结构和快速推理能力,适用于实时应用场景

    语义分割端侧AIFP16
  • DeepLab-V3-Plus (MobileNet) 官方介绍图;非本站板卡实测画面图像分割
    Google ResearchMIT

    DeepLabV3+

    是一种基于MobileNet的先进模型,专注于语义分割,采用空洞卷积提升精度。

    语义分割端侧AIFP16
  • PP-HumanSegV2-Lite 官方介绍图;非本站板卡实测画面图像分割
    PaddlePaddleApache-2.0

    PP-HumanSegV2-Lite

    一种轻量级人体分割模型,专为移动设备和资源有限的场景设计,在保证分割精度的同时显著降低计算成本。

    语义分割端侧AIW8A8
  • YOLO11n-Pose 官方介绍图;非本站板卡实测画面姿态估计
    UltralyticsAGPL-3.0

    YOLO11n-Pose

    极致轻量的实时人体姿态估计模型

    姿态估计端侧AIFP16
  • MediaPipe-Pose (Full) 官方介绍图;非本站板卡实测画面姿态估计
    Google ResearchApache-2.0

    MediaPipe-Pose

    一种实时人体姿态估计模型,能够精准检测人体关键点,用于健康、健身和AR等领域

    人体关键点运动分析FP16

指标说明

时延:
模型单次推理耗时(ms),不含前后处理;LLM 生成速度 tokens/s;语音 RTF = 处理时长 / 音频时长,越小越快。
精度损失:
相对模型自身浮点版本的指标下降。所有数字为真机实测,标注后端版本与日期;没有实测写“—”。